
logistic distribution
设X是连续随机变量,X服从逻辑斯谛分布是指X具有下列分布函数和密度函数:
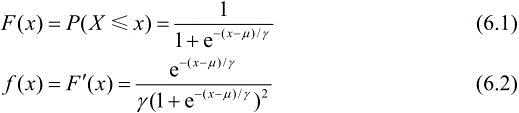
式中,μ为位置参数,γ>0为形状参数。
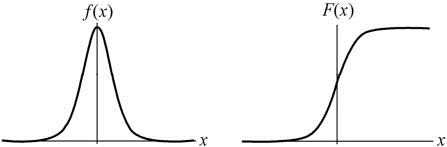
密度函数是脉冲函数
分布函数是一条Sigmoid曲线(sigmoid curve)即为阶跃函数
?
?
二项逻辑斯谛回归模型
二项逻辑斯谛回归模型是如下的条件概率分布
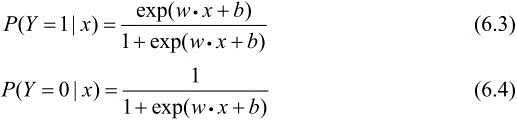
x?Rn是输入,Y?{0,1}是输出,w?Rn和b?R是参数,
w称为权值向量,b称为偏置,w·x为w和x的内积。
可以求得P(Y=1|x)和P(Y=0|x)。
逻辑斯谛回归比较两个条件概率值的大小,将实例x分到概率值较大的那一类。
定义几率(0dds):该事件发生的概率与该事件不发生的概率的比值
引申出log odds:
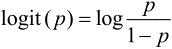
对于logistic regression而言,log odds如下:
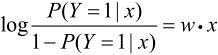
在LR中,输出Y=1的对数几率是输入x的线性函数。
或者说,输出Y=1的对数几率是由输入x的线性函数表示的模型,即LR模型。
?
LR模型参数估计
可以应用极大似然估计法估计模型参数
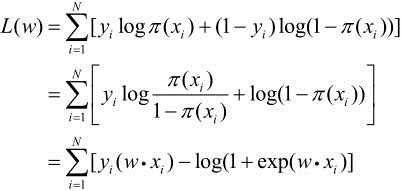
对L(w)求极大值,得到w的估计值。
问题就变成了以对数似然函数为目标函数的最优化问题。
LR学习中通常采用的方法是梯度下降法及拟牛顿法。
?
?
最大熵模型
最大熵原理认为,学习概率模型时,在所有可能的概率模型(分布)中,
熵最大的模型是最好的模型。通常用约束条件来确定概率模型的集合,
所以,最大熵原理也可以表述为在满足约束条件的模型集合中选取熵最大的模型。
X的概率分布是P(X),则其熵

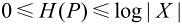
|X|是X的取值个数,当且仅当X的分布是均匀分布时右边的等号成立。
这就是说,当X服从均匀分布时,熵最大
?
直观地,最大熵原理认为要选择的概率模型首先必须满足已有的事实,
即约束条件。在没有更多信息的情况下,那些不确定的部分都是"等可能的"。
最大熵原理通过熵的最大化来表示等可能性。"等可能"不容易操作,
而熵则是一个可优化的数值指标。
?
最大熵模型的定义
给定训练数据集(传统训练集)
可以确定
联合分布P(X,Y)的经验分布
边缘分布P(X)的经验分布
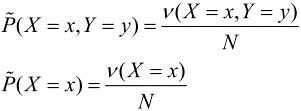
v(X=x,Y=y)表示训练数据中样本(X,Y)出现的频数
v(X=x)表示训练数据中输入x出现的频数,N表示训练样本容量。
特征函数f(X,Y)关于经验分布p(X,Y)的期望
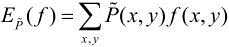
特征函数f(X,Y)关于模型P(Y|X)与经验分布
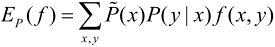
如果模型能够获取训练数据中的信息,那么就可以假设这两个期望值相等
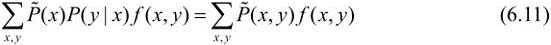
作为模型学习的约束条件。假如有n个特征函数fi(X,Y),i=1,2,…,n,那么就有n个约束条件
?
最大熵模型
假设满足所有约束条件的模型集合为
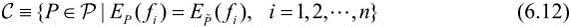
定义在条件概率分布P(Y|X)上的条件熵
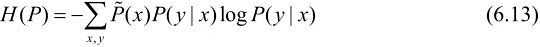
则模型集合C中条件熵H(P)最大的模型称为最大熵模型
?
最大熵模型的学习
最大熵模型的学习过程就是求解最大熵模型的过程。
最大熵模型的学习可以形式化为约束最优化问题。
数据集T={(x1,y1),(x2,y2),…,(xN,yN)}以及
特征函数fi(X,Y),i=1,2,…,n,最大熵模型的学习等价于约束最优化问题:
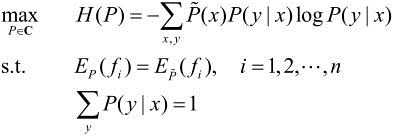
将最大化改为最小化:
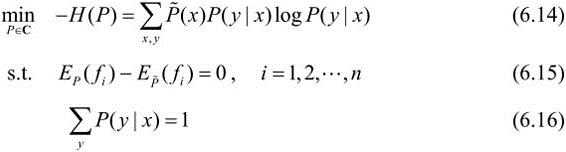
将约束最优化的原始问题转换为无约束最优化的对偶问题。
通过求解对偶问题求解原始问题。
?
引进拉格朗日乘子w0,w1,w2,…,wn,定义拉格朗日函数L(P,w):
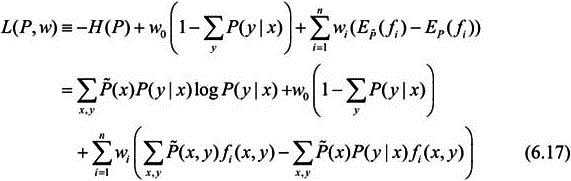
原始问题:

对偶问题:

由于拉格朗日函数L(P,w)是P的凸函数
原始问题(6.18)的解与对偶问题(6.19)的解是等价的。
首先是内部的极小化问题:
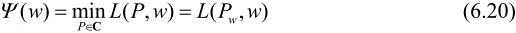
同时,记Pw :
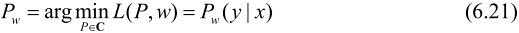
求L(P,w)对P(Y|X)的偏导数:
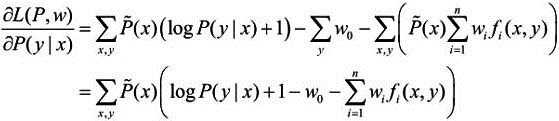
令偏导数等于0得:
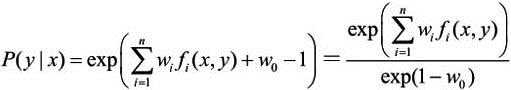
由于:

得:
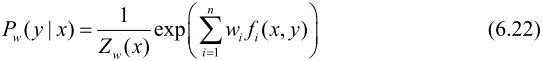
其中:
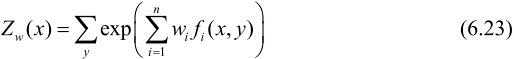
Zw(x)称为规范化因子;fi(X,Y)是特征函数;wi是特征的权值。
表示的模型Pw=Pw(Y|X)就是最大熵模型。
然后求解对偶问题外部的极大化问题:

也就是说,最大熵模型的学习归结为对偶函数的极大化。
?
下面证明对偶函数的极大化等价于最大熵模型的极大似然估计。
已知训练数据的经验概率分布
条件概率分布P(Y|X)的对数似然函数表示为
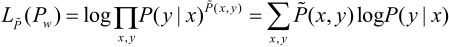
当条件概率分布P(Y|X)是最大熵模型,
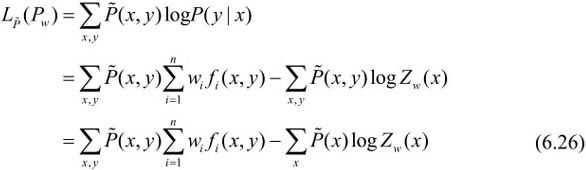
再看对偶函数
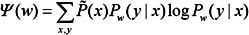
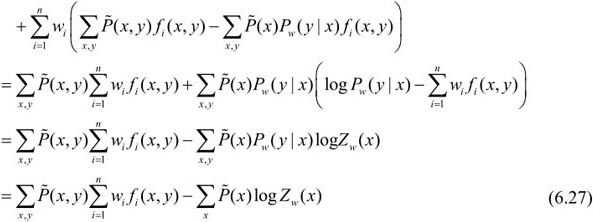
于是证明了最大熵模型学习中的对偶函数极大化等价于最大熵模型的极大似然估计
最大熵模型的学习问题转换为具体求解对数似然函数极大化或对偶函数极大化的问题
更为一般形式的:
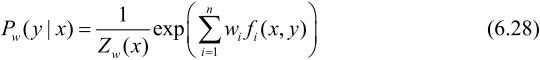


其中,
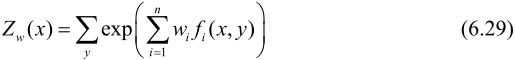
最大熵模型与LR模型有类似的形式,它们又称为对数线性模型(log linear model)
模型学习就是在给定的训练数据条件下对模型进行极大似然估计或正则化的极大似然估计
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
?
原文:http://www.cnblogs.com/LauenWang/p/4572356.html