
SQL SERVER的锁机制(一)——概述(锁的种类与范围)
SQL SERVER的锁机制(二)——概述(锁的兼容性与可以锁定的资源)
SQL SERVER的锁机制(三)——概述(锁与事务隔离级别)
SQL SERVER的锁机制(四)——概述(各种事务隔离级别发生的影响)
锁定:通俗的讲就是加锁。锁定是 Microsoft SQL Server 数据库引擎用来同步多个用户同时对同一个数据块的访问的一种机制。
定义:当有事务操作时,数据库引擎会要求不同类型的锁定,如相关数据行、数据页或是整个数据表,当锁定运行时,会阻止其他事务对已经锁定的数据行、数据页或数据表进行操作。只有在当前事务对于自己锁定的资源不在需要时,才会释放其锁定的资源,供其他事务使用。
一、锁的种类与范围(如下表)
|
锁类型 |
说明 |
|
共享 (S) |
用于不更改或不更新数据的读取操作,如 SELECT 语句。 |
|
更新 (U) |
用于可更新的资源中。 防止当多个会话在读取、锁定以及随后可能进行的资源更新时发生常见形式的死锁。 |
|
独占(也可称排他)(X) |
用于数据修改操作,例如 INSERT、UPDATE 或 DELETE。 确保不会同时对同一资源进行多重更新。 |
|
意向 |
用于建立锁的层次结构。 意向锁包含三种类型:意向共享 (IS)、意向排他 (IX) 和意向排他共享 (SIX)。 |
|
架构 |
在执行依赖于表架构的操作时使用。 架构锁包含两种类型:架构修改 (Sch-M) 和架构稳定性 (Sch-S)。 |
|
大容量更新 (BU) |
在向表进行大容量数据复制且指定了 TABLOCK 提示时使用。 |
|
键范围 |
当使用可序列化事务隔离级别时保护查询读取的行的范围。 确保再次运行查询时其他事务无法插入符合可序列化事务的查询的行。 |
(一)共享锁
共享锁(S 锁)允许并发事务在封闭式并发控制下读取 (SELECT) 资源。
当查询(SELECT)某条记录时,SQL SERVER 会尝试取得该条记录的上存在共享锁(S 锁),或无法获取,就必须等待别人释放对该记录中某几种与共享锁互斥的锁,才能在设置共享锁之后,获取该条记录。
举例来说:当某人查询某张表的一条记录时,就会在该记录上放置共享锁,在而其他人也要查询这张表的此记录时,因为共享锁彼此不互斥,所以也可以再次放置共享锁,也就是说SQL SERVER允许不同连接同时读取相同的数据。如果此时有人要更新此记录,因为独占锁与共享锁互斥,所以无法放置独占锁,要等到所有读取此记录的人都读取完毕,释放了共享锁,更新数据的人才能对该记录设置独占锁,并进一步更新数据。一般情况下,在默认的事务隔离级别下,当数据读取完毕,SQL SERVER就会释放共享锁,除非有特别的设置。
(二)更新锁
更新锁是一种中继锁。当同一项资源从原来的查询操作转换为更新操作时,锁定机制会从共享锁变为更新锁,再进一步变成独占锁。
在可重复读或可序列化事务中,此事务读取数据 [获取资源(页或行)的共享锁(S 锁)],然后修改数据 [此操作要求锁转换为独占锁(X 锁)]。 如果两个事务获得了资源上的共享模式锁,然后试图同时更新数据,则一个事务尝试将锁转换为独占锁(X 锁)。 共享模式到独占锁的转换必须等待一段时间,因为一个事务的独占锁与其他事务的共享模式锁不兼容;发生锁等待。 第二个事务试图获取独占锁(X 锁)以进行更新。 由于两个事务都要转换为独占锁(X 锁),并且每个事务都等待另一个事务释放共享模式锁,因此发生死锁。
若要避免这种潜在的死锁问题,请使用更新锁(U 锁)。 一次只有一个事务可以获得资源的更新锁(U 锁)。 如果事务修改资源,则更新锁(U 锁)转换为独占锁(X 锁)。
例如,当查询一条记录后,要将此内容更新(Update语句加上Where条件),一定会先查找记录,在查找的过程中就会对相关的记录放置共享锁,等找到相应的记录之后,SQL SERVER 会先对记录放置更新锁,以避免发生死锁。因为共享锁与更新锁并不互斥,如果两个人同时对同一条记录放置共享锁,先进行更新的人,可以在别人也对同一条记录放置了共享锁时,继续放置更新锁,但因为更新锁互斥,所以当另一个人想再放置更新锁时,将无法设置,而进入停止等待状态。
(三)独占锁(也可称为排他锁)
独占锁(排他锁)(X 锁)可以防止并发事务对资源进行访问。 使用独占锁(X 锁)时,任何其他事务都无法修改数据;仅在使用 NOLOCK 提示或未提交读隔离级别时才会进行读取操作。
对数据进行添加、修改、删除操作时(如 INSERT、UPDATE 和 DELETE), 语句在执行所需的操作之前首先执行读取操作以获取数据。 因此,需先对所在的资源放置独占锁,以确保以上操作未完成时,不受到干扰,独占锁在开启事务之后,一直保留到事务结束。例如,UPDATE 语句可能根据与一个表的联接修改另一个表中的行。 在此情况下,除了请求更新行上的独占锁之外,UPDATE 语句还将请求在联接表中读取的行上的共享锁。
(四)意向锁
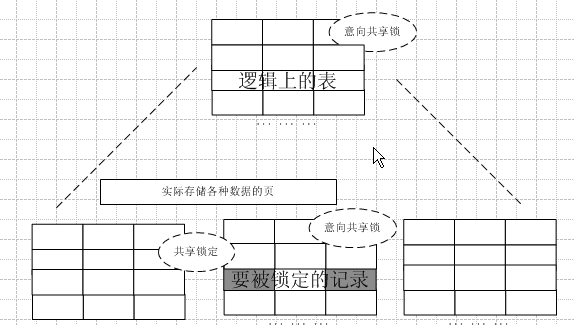
在记录上放置共享锁之前,需要对存放该记录的更大范围(如数据页或数据表)上设置意向锁,以避免其他连接对该页放置独占锁。
数据库引擎使用意向锁来保护共享锁(S 锁)或独占锁(X 锁)放置在锁层次结构的底层资源上。 意向锁之所以命名为意向锁,是因为在较低级别锁前可获取它们,因此会通知意向将锁放置在较低级别上。
意向锁有两种用途:
· 防止其他事务以会使较低级别的锁无效的方式修改较高级别资源。
· 提高数据库引擎在较高的粒度级别检测锁冲突的效率。
例如,在该表的数据页或数据行上请求共享锁(S 锁)之前,在表级(或页级)请求共享意向锁,以防止另一个事务随后在包含那一页的表上尝试放置独占锁(X 锁)。 意向锁可以提高性能,因为数据库引擎仅在表级检查意向锁来确定事务是否可以安全地获取该表上的锁。 而不需要检查表中的每行或每页上的锁以确定事务是否可以锁定整个表。如下图。
意向锁包括意向共享 (IS)、意向排他 (IX) 以及意向排他共享 (SIX)等等。各种意向锁的说明,如下表。
|
锁类型 |
说明 |
|
意向共享 (IS) |
保护针对层次结构中某些(而并非所有)低层资源请求或获取的共享锁。 |
|
意向独占 (IX) |
保护针对层次结构中某些(而并非所有)低层资源请求或获取的独占锁。 IX 是 IS 的超集,它也保护针对低层级别资源请求的共享锁。 |
|
意向独占共享 (SIX) |
保护针对层次结构中某些(而并非所有)低层资源请求或获取的共享锁以及针对某些(而并非所有)低层资源请求或获取的意向独占锁。 顶级资源允许使用并发 IS 锁。 例如,获取表上的 SIX 锁也将获取正在修改的页上的意向独占锁以及修改的行上的独占锁。 虽然每个资源在一段时间内只能有一个 SIX 锁,以防止其他事务对资源进行更新,但是其他事务可以通过获取表级的 IS 锁来读取层次结构中的低层资源。 |
|
意向更新 (IU) |
保护针对层次结构中所有低层资源请求或获取的更新锁。 仅在页资源上使用 IU 锁。 如果进行了更新操作,IU 锁将转换为 IX 锁。 |
|
共享意向更新 (SIU) |
S 锁和 IU 锁的组合,作为分别获取这些锁并且同时持有两种锁的结果。 例如,事务执行带有 PAGLOCK 提示的查询,然后执行更新操作。 带有 PAGLOCK 提示的查询将获取 S 锁,更新操作将获取 IU 锁。 |
|
更新意向排他 (UIX) |
U 锁和 IX 锁的组合,作为分别获取这些锁并且同时持有两种锁的结果。 |
下面来实际举例来说明
--示例代码一:

SET TRANSACTION ISOLATION LEVEL REPEATABLE READ

BEGIN TRAN

SELECT * FROM [Book] WHERE [bookid]=1

WAITFOR DELAY ‘00:00:10‘

COMMIT TRAN
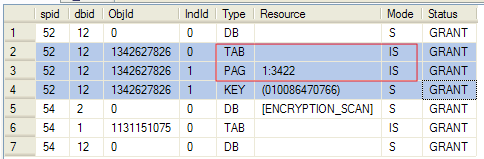
可以通过另一条连接执行SP_LOCK 来查看上面代码的执行结果,如下图。在数据表上与数据页上都放置了意向共享锁,而在锁定的记录上放置了共享锁。
--示例代码二:

SET TRANSACTION ISOLATION LEVEL REPEATABLE READ

BEGIN TRAN

SELECT * FROM [WBK_PDE_LIST] WHERE [WBOOK_NO]=‘BE404942450020‘ and cop_g_no=‘60217445‘

WAITFOR DELAY ‘00:00:10‘

COMMIT TRAN
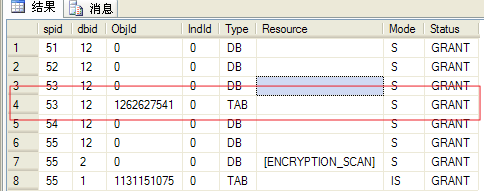
可以通过另一条连接执行SP_LOCK 来查看上面代码的执行结果,如下图。由于上述代码中的[WBK_PDE_LIST]是一张堆表,所以直接就对数据表加了共享锁。
对上述示例中表WBK_PDE_LIST添加索引,
CREATE NONCLUSTERED INDEX [IX_WBK_PDE_LIST_WBOOKNO] ON [dbo].[WBK_PDE_LIST]

(

[WBOOK_NO] ASC,

[COP_G_NO] ASC

)WITH (PAD_INDEX  = OFF, STATISTICS_NORECOMPUTE  = OFF, SORT_IN_TEMPDB = OFF, IGNORE_DUP_KEY = OFF, DROP_EXISTING = OFF

, ONLINE = OFF, ALLOW_ROW_LOCKS  = ON, ALLOW_PAGE_LOCKS  = ON) ON [PRIMARY]

GO
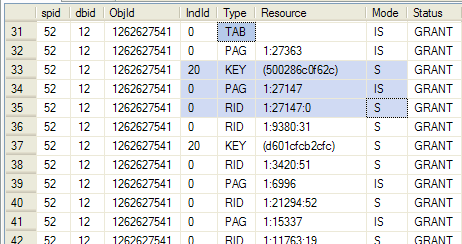
然后再次执行代码示例二,再打开一个新的查询分析器,在查询分析器中执行SP_LOCK 来查看上面代码的执行结果,如下图。在数据表与数据页上分别放置了意向共享锁,在索引与数据行上放置了共享锁。
(五)架构锁
数据库引擎在表数据定义语言 (DDL) 操作(例如添加列或删除表)的过程中使用架构修改 (Sch-M) 锁。 保持该锁期间,Sch-M 锁将阻止对表进行并发访问。 这意味着 Sch-M 锁在释放前将阻止所有外围操作。
某些数据操作语言 (DML) 操作(例如表截断)使用 Sch-M 锁阻止并发操作访问受影响的表。
数据库引擎在编译和执行查询时使用架构稳定性 (Sch-S) 锁。 Sch-S 锁不会阻止某些事务锁,其中包括排他 (X) 锁。 因此,在编译查询的过程中,其他事务(包括那些针对表使用 X 锁的事务)将继续运行。 但是,无法针对表执行获取 Sch-M 锁的并发 DDL 操作和并发 DML 操作。
(六)大容量更新锁
数据库引擎在将数据大容量复制到表中时,指定 TABLOCK 提示或使用 sp_tableoption 选项(将数据表设置为 table lock on bulk load),则是使用大容量更新锁(BU)。 大容量更新锁(BU 锁)允许多个线程将数据并发地大容量加载到同一表,以降低数据表的锁定竞争,同时防止其他不进行大容量加载数据的进程访问该表。
(七)键范围锁
在使用可序列化事务隔离级别时,保护用户对于查询时所读取的数据行范围,以确保其他事务无法插入受“键范围锁”保护的数据行。键范围锁放置在索引上,指定开始与结束的索引键值。这些操作会先在索引上获取锁定,此种锁定可以封锁任何尝试进行插入、修改、删除索引键值在“键范围锁”中的数据行。例如:在索引键值“AAA”至“CZZ”范围中放置键范围锁,避免其他事务将含有索引键值的数据行插入到该范围内的任何地方,例如:“ABC”、“BCD”、“CEF”。另外当UPDATE语句搭配WHERE子句时,当SQL SERVER还在查找数据时,也有可能会设置键范围锁。
二、完整的锁兼容性矩阵(见下图)
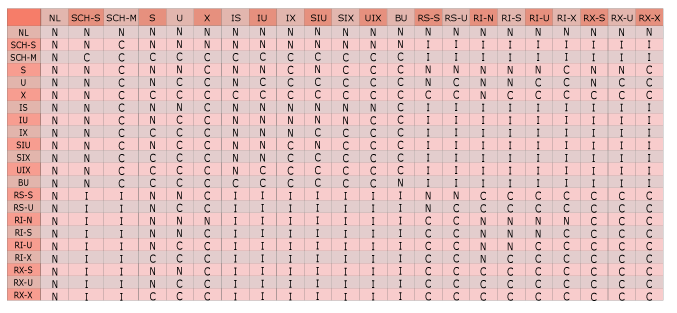
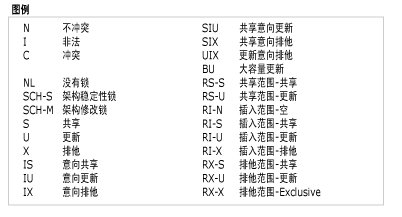
对上图的是代码说明:见下图。
三、下表列出了数据库引擎可以锁定的资源。
|
名称 |
资源 |
缩写 |
编码 |
呈现锁定时,描述该资源的方式 |
说明 |
|
数据行 |
RID |
RID |
9 |
文件编号:分页编号:Slot编号 |
用于锁定堆中的单个行的行标识符。 |
|
索引键 |
KEY |
KEY |
7 |
6字节哈希值 |
索引中用于保护可序列化事务中的键范围的行锁。 |
|
分页 |
PAGE |
PAG |
6 |
文件编号:分页编号 |
数据库中的 8 KB 页,例如数据页或索引页。 |
|
范围 |
EXTENT |
EXT |
8 |
文件编号:范围的第一个分页的编号 |
一组连续的八页,例如数据页或索引页。 |
|
HoBT |
堆或 B 树。 用于保护没有聚集索引的表中的 B 树(索引)或堆数据页的锁。 |
||||
|
数据表 |
TABLE |
TAB |
5 |
数据表ID(OBJID字段) |
包括所有数据和索引的整个表。 |
|
文件 |
FILE |
FIL |
3 |
文件编号 |
数据库文件。 |
|
应用程序 |
APPLICATION |
APP |
10 |
6字节哈希值 |
应用程序专用的资源。 |
|
METADATA |
元数据锁。 |
||||
|
ALLOCATION_UNIT |
分配单元。 |
||||
|
数据库 |
DATABASE |
DB |
2 |
数据库代码(DBID字段) |
整个数据库。 |
|
索引 |
IDX |
4 |
Db_id:object_id:index_id相关的其他资源 |
索引中的数据行锁定, |
四、SQL SERVER要锁定资源时,默认是从最底级开始锁起,例如,索引键值,数据行,以避免大范围锁定,以避免影响其他人同时访问该范围内的其他数据,但是当内存不足时,SQL SERVER会自动扩大锁定范围以减低管理锁定的负荷。下面我们来看一个示例。
--建立SP_LOCK输出缓存表

if exists( select * from tempdb..sysobjects where name like ‘#temp%‘ and type =‘u‘)

begin

drop table #temp

create table #temp(spid int,dbid int ,objid int,indid int,type varchar(3),resource varchar(20)

,mode varchar(20),status varchar(5))

end

begin tran

update WBK_PDE_head set [COP_EMS_NO]=‘abcde‘ where wbook_no=‘BE404942850177‘

insert #temp exec sp_lock @@spid

commit tran


-----获取dbid

--select DB_ID(‘Test‘)

--只查看定制的数据库的相关资源,sql 2008

select spid,数据库=DB_NAME(dbid),对象=OBJECT_NAME(objid),

索引=(select name from sysindexes where ID=OBJID and indid=t.indid ),

TYPE,resource,mode,status from #temp t where dbid=28

order by dbid,objid,indid

---

---以SQL 2005的sys.indexes表查询相关数据


select spid,数据库=DB_NAME(dbid),对象=OBJECT_NAME(objid),

索引=(select name from sys.indexes where object_id=OBJID and index_id=t.indid ),

TYPE,resource,mode,status from #temp t where dbid=28

order by dbid,objid,indid
说明:
1.建立临时表#Temp用以存储系统存储过程sp_lock输出的数据
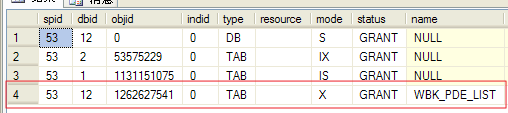
2.开启事务,然后更新数据(update),但不去确认事务,数据库会锁定相关对象,将sp_lock所呈现的相关数据插入到#Temp表中,并将结果查询出来。
在查询分析器中执行以下代码
select a.*,b.name from #temp a left join sysobjects b on a.objid=b.id

order by a.type
图如下示:
五、锁与事务隔离级别
事务隔离级别简单的说,就是当激活事务时,控制事务内因SQL语句产生的锁定需要保留多入,影响范围多大,以防止多人访问时,在事务内发生数据查询的错误。设置事务隔离级别将影响整条连接。
SQL Server 数据库引擎支持所有这些隔离级别:
· 未提交读(隔离事务的最低级别,只能保证不读取物理上损坏的数据)
· 已提交读(数据库引擎的默认级别)
· 可重复读
· 可序列化(隔离事务的最高级别,事务之间完全隔离)
SQL Server 还支持使用行版本控制的两个事务隔离级别。一个是已提交读隔离的新实现,另一个是新事务隔离级别(快照)。
设置语句如下:
|
SET TRANSACTION ISOLATION LEVEL { READ UNCOMMITTED | READ COMMITTED | REPEATABLE READ | SNAPSHOT | SERIALIZABLE } [ ; ] |
(一)未提交读
未提交读是最低的事务隔离级别,允许读取其他事务已经修改但未提交的数据行。SQL SERVER 当此事务等级进行尝试读取数据时,不会放置共享锁,直接读取数据,所以忽略已存在的互斥锁。换句话说,即使该资源已经受到了独占锁的保护,当使用未提交读隔离级别时,此数据还是可以被读取,加快查询速度,但是会读取到别人未修改的数据,所以此种读取被称为脏读。此种隔离级别适合不在乎数据变更的查询场景。此隔离级别与SELECT 语句搭配 NOLOCK 所起到的效果相同
未提交读示例:
--1.--1.创建测试表
create table tbUnRead
(ID INT,
name nvarchar(20)
)
--2新增记录
insert tbUnRead
select 1,‘Tom‘
union
select 2,‘Jack‘
--3开启事务,并进行更新
begin tran
update tbUnRead
set name=‘Jack_upd‘
where ID=2
---4查询事务数量(由于没有回滚或提交事务)
SELECT @@TRANCOUNT
事务查询结果如下:

--5打开另一条连接,设置事务隔离级别为(未提交读)
set Transaction isolation level read uncommitted
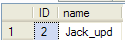
--6查询数据,查询到的数据是修改之后的数据。
select * from tbUnRead where ID=2
如下图:
(二)已提交读
已提交读是SQL SERVER 默认的事务隔离级别。当事务正在读取数据时,SQL SERVER 会放置共享锁以防止其他事务修改数据,当数据读取完成之后,会自动释放共享锁,其他事务可以进行数据修改。因为共享锁会同时封锁封锁语句执行,所以在事务完成数据修改之前,是无法读取该事务正在修改的数据行。因此此隔离级别可以防止脏读。
在SQL SERVER 2005以上版本中,如果设置READ_COMMITTED_SNAPSHOT为ON,则已提交读的事务全使用数据行版本控制的隔离下读取数据。读取操作不会获取正被读取的数据上的共享锁(S 锁),因此不会阻塞正在修改数据的事务。同时,由于减少了所获取的锁的数量,因此最大程度地降低了锁定资源的开销。使用行版本控制的已提交读隔离和快照隔离旨在提供副本数据的语句级或事务级读取一致性。
示例一:设置READ_COMMITTED_SNAPSHOT为OFF
--1.创建测试表
create table tbUnRead
(ID INT,
name nvarchar(20)
)
--2新增记录
insert tbUnRead
select 1,‘Tom‘
union
select 2,‘Jack‘
--3开启事务,并进行更新
begin tran
update tbUnRead
set name=‘Jack_upd‘
where ID=2
---4查询事务数量(由于没有回滚或提交事务)
SELECT @@TRANCOUNT
--5打开另一条连接,设置事务隔离级别为(已提交读)
set Transaction isolation level read committed
--6查询数据,由于当前事务没有提交,所以无法查询数据
select * from tbUnRead where ID=2
6查询数据的结果 如下图:
示例二:设置READ_COMMITTED_SNAPSHOT为ON
use master
go
---创建测试数据库
create database read_committed_SNAPSHOT_Test
go
---激活数据行版本控制
alter database read_committed_SNAPSHOT_Test set read_committed_SNAPSHOT on
go
use read_committed_SNAPSHOT_Test
go
--1.创建测试表
create table tbReadLevel
(ID INT,
name nvarchar(20)
)
--2新增记录
insert tbReadLevel
select 1,‘测试‘
go
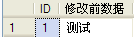
select ID,name as "修改前数据" from tbReadLevel
如下图:
go
--3开启事务,并进行更新
begin tran
update tbReadLevel
set name=‘Jack_upd‘
where ID=1
---4查询事务数量(由于没有回滚或提交事务)
SELECT @@TRANCOUNT
--5打开另一条连接,设置事务隔离级别为(已提交读)
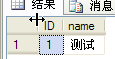
--查询数据,查询到的数据是上一次提交的数据
select * from tbReadLevel where ID=1
5的查询结果如下图:
(三)可重复读
可重复读事务隔离级别在事务过程中,所有的共享锁均保留到事务结束,而不是读取结束就释放,这与已提交读的行为截然不同,虽然在事务过程中,重复查询相同记录时不受其他事务的影响,但可能由于锁定数据过久,而导致其他人无法处理数据,影响并发率,更严重的可能提高发生死锁的机率。
总之,如果使用可重复读隔离级别读取数据,数据读出之后,其他事务只能对此范围中的数据进行读取或新增,但不可以进行修改,直到读取事务完成。因此,使用此隔离级别需要谨慎小心,根据实际情况进行设置。
示例:
--1.创建测试表
create table tbUnRead
(ID INT,
name nvarchar(20)
)
--2新增记录
insert tbUnRead
select 1,‘Tom‘
union
select 2,‘Jack‘
--3设置事务隔离级别为(可重复读)
set Transaction isolation level REPEATABLE READ
--4开启事务,并进行更新
begin tran
--5查询数据
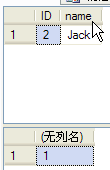
select * from tbUnRead where ID=2
---6查询事务数量(没有回滚或提交事务)
SELECT @@TRANCOUNT
5与6的执行结果如下图
---7开启另一条连接,查询数据与修改数据
---事务虽然没有完成,但可以查询到之前的数据
select * from tbUnRead where ID=2
Go
---8,修改数据,由于事务没有完成,所以无法进行修改
update tbUnRead
set name=‘Jack_upd‘
where ID=2
go
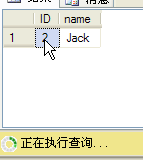
--7、8的执行结果如下,可以查询数据,但无法更新数据,如下图。
(四)快照
快照隔离级别是SQL SERVER 2005之后版本新增的隔离级别,开启之后,允许事务过程中读取操作不受异动影响,事务中任一语句所读取的数据,均予事务激活时,就已经完成提交,符合事务一致性的数据行版本。所以只能查核事务激活之前已经完成提交的数据,也就是说可以查询已经完成提交的数据行快照集,但看不见已激活的事务正在进行修改的数据行。当使用快照隔离级别读取数据时不会要求对数据进行锁定,如果所读取的记录正在被某事务进行修改,它也会读取此记录之前已经提交的数据。故当某记录被事务进行修改时,SQL SERVER的TEMPDB数据库会存储最近提交的数据行,以供快照隔离级别的事务读取数据时使用。将Allow_SNAPSHOT_isolation设为ON,事务就会设置快照隔离级别。
use master
go
---创建测试数据库(快照)
create database SNAPSHOT_Test
go
---激活数据行版本控制
alter database SNAPSHOT_Test set Allow_SNAPSHOT_isolation on
go
use SNAPSHOT_Test
go
--1.创建测试表
create table tbReadLevel
(ID INT,
name nvarchar(20)
)
--2新增记录
insert tbReadLevel
select 1,‘测试‘
union
select 2,‘快照测试‘
go
select ID,name as "修改前数据"
from tbReadLevel
go
--3开启事务,并进行更新
begin tran
update tbReadLevel
set name=‘Jack_upd_快照‘
where ID=1
---4查询事务数量(没有回滚或提交事务)
SELECT @@TRANCOUNT
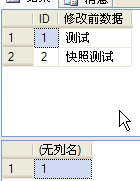
--2、4的执行结果,如下图。
--5打开另一条连接,设置事务隔离级别为(快照)
set Transaction isolation level SNAPSHOT
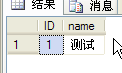
--6查询数据,查询的数据是上一次提交的数据
select * from tbReadLevel where ID=1
(五)可序列化
可序列化是事务隔离级别中最高的级别,为最严谨的隔离级别,因为它会锁定整个范围的索引键,使事务与其他事务完全隔离。在现行事务完成之前,其他事务不能插入新的数据行,其索引键值存在于现行事务所读取的索引键范围之中。此隔离级别与Select 搭配holdlock效果一样。
示例:
--1.创建测试表
create table tbUnRead
(ID INT,
name nvarchar(20)
)
--2新增记录
insert tbUnRead
select 1,‘Tom‘
union
select 2,‘Jack‘
--3设置事务隔离级别为(可序列化)
set Transaction isolation level SERIALIZABLE
--5开启事务,并进行更新
begin tran
select * from tbUnRead where ID=2
---6查询事务数量(没有回滚或提交事务)
SELECT @@TRANCOUNT
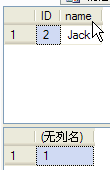
5、6执行结果如下图。
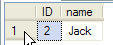
---7,开启另一条连接,查询数据,可以查询到之前的数据
select * from tbUnRead where ID=2
---8,修改数据,无法修改数据
update tbUnRead
set name=‘Jack_upd‘
where ID=2
--新增数据,无法插入数据
insert tbUnRead
select 3,‘May‘
六、各种事务隔离级别发生的影响
修改数据的用户会影响同时读取或修改相同数据的其他用户。即这些用户可以并发访问数据。如果数据存储系统没有并发控制,则用户可能会看到以下负面影响:
· 未提交的依赖关系(脏读)
· 不一致的分析(不可重复读)
· 幻读
(一)脏读:
例:张某正在执行某项业务,如下:
begin tran

insert tbUnRead

select 3,‘张三‘

union

select 4,‘李四‘

---延迟秒,模拟真实交易情形,用于处理业务逻辑

waitfor delay ‘00:00:05‘

rollback tran

---此时李某对表中数据进行查询,执行了以下语句:

set Transaction isolation level read uncommitted

--查询数据

select * from tbUnRead where name like ‘张%‘
则李某可以看到张某所执行的插入语句,把数据添加到了数据库,如下图。
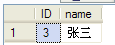
但是张某最终是没有提交事务,而是回滚了事务,所以这条记录并没有真正插入到数据库中。从而发生李某将脏读的数据当成真实的查询结果。
要解决此问题,就是要把数据库的事务隔离级别由未提交读修改成已提交读。只有当查询结果的正确性不是非常重要,或者是隔一段时间查询一次情况下,即使这一次查询结果是错,而下次查询结果是对的,并不会有太大影响,这才适合使用未提交读。
(二)不可重复读
例:张某正在查询数据,如下
set Transaction isolation level read committed

begin tran

select * from tbUnRead  where ID=2


---延迟秒,模拟真实交易情形,用于处理业务逻辑

waitfor delay ‘00:00:05‘

select * from tbUnRead  where ID=2


commit tran

---此时李对表中数据进行了更新,如下语句:

update tbUnRead

set name=‘Jack_upd‘

where ID=2
上面的执行语句造成张某在同一个事务内,两次相同的查询条件,查询到不相同的结果(如下图)。
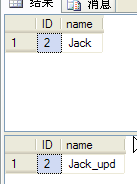
这是由于“已提交读”隔离级别对共享锁保留的时间是:一旦查询完毕就立即释放,而非事务完成才释放。所在张某虽然还在使用事务,事务过程中的所有独占锁都会一直保留,让事务中所更改的数据别人不可进行查询与更改,直到事务完成。但是,被查询的数据在事务过程中是查询完毕就立即释放共享锁,所以别人仍然可以进行修改,造成一笔事务中,两次相同的查询条件,可以得到不相同的结果。最佳的解决方案是将隔离级别设置为“可重复读”。
“可重复读”事务隔离级别,让事务过程中所曾经建立的共享锁都一直保留到事务完成,虽然可以避免“不可重复读”的问题,但是也会导致数据锁定太久,而别人无法读取数据,影响并发率,甚至提高了“死锁”的发生率。
(三)幻读
例:张某正在查询数据,如下
set Transaction isolation level REPEATABLE READ

begin tran

select * from tbUnRead  where ID=3


---延迟秒,模拟真实交易情形,用于处理业务逻辑

waitfor delay ‘00:00:05‘

select * from tbUnRead  where ID=3


commit tran


--此时李某新增了一条记录,如下语句:

INSERT TBUNread

select 3,‘幻读‘
张某已经把隔离级别设置为“可重复读”,虽然是曾经读取的数据,不管是共享锁还是互斥锁都 保留到了事务结束,但是无法阻止其他人运行新增操作,导致第一次查询时没有数据,第二次查询时却有了数据。被称为“幻读”。如下图。
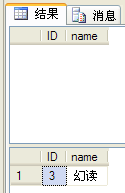
为了避免此类问题,可以将隔离级别设置为“可序列化”,设置之后,则其他人则无法新增数据。
七、各隔离级别所能防止的访问错误
|
隔离级别 |
脏读 |
不可重复读 |
幻读 |
|
未提交读 |
是 |
是 |
是 |
|
已提交读 |
否 |
是 |
是 |
|
可重复读 |
否 |
否 |
是 |
|
快照 |
否 |
否 |
否 |
|
可序列化 |
否 |
否 |
否 |
八、常用锁与事务隔离级别间的交互影响
|
已提交读 |
可重复读 |
快照 |
可序列化 |
|
|
共享 |
读完数据后就释放 |
事务结束才释放 |
不加锁,以版本来控制 |
事务结束才释放 |
|
更新 |
读完数据后就释放或是升级成独占锁 |
读完数据后就释放或是升级成独占锁 |
不加锁,以版本来控制 |
读完数据后就释放或升级成独占锁 |
|
独占 |
事务结束才释放 |
事务结束才释放 |
不加锁,以版本来控制 |
事务结束才释放 |
九、动态锁定管理
数据库引擎使用动态锁定管理策略来控制锁定和系统的最佳成本效益。数据库引擎可以动态调整数据粒度与锁定类型,当使用最低一级的行锁而非更大范围的页锁时,可以降低两个事务要求相同范围的数据锁定的可能性,增强并行访问的能力,可同时服务更多的用户,减小死锁的机率。相反低级锁转为高级锁可以减小系统的资源负担,但会增加并行争用的可能性。
此机制由锁管理器进行管理,每一个锁都需要内存去记录,并且要与锁管理器进行合作,才能完成数据访问操作,你可以想像当表中有100万条记录时,你执行一条没有where语句的update指令时,在默认情况下数据库引擎会采用行锁,但这要记录100万条行锁记录,以及相关的意向共享锁,必定会消耗掉大量的系统资源,当系统资源不足时,数据库引擎会自动提升锁的级别,也就是由行锁提升为页锁,如果资源还是不足,则会再次提升,提升为表锁。
就以上例子来说,如果每个页可以放200条记录,则100万表记录的行锁转为5000个页锁,还省掉了大量的意向共享锁。如果资源还是一足,则可以再次提升锁级别,提升到表锁,这样就只需要一个锁就可以了。
愈大范围的锁花费在管理锁之上的资源就愈少。但相对来说,同时上线并发访问该资源的人数就越少。例如:或采用行锁,则你访问你的记录,我访问我的记录,互相不影响,但如果升级到页锁,则如果你先抢到该分页,而我要访问的记录又恰恰在这一分页上,则我必须要等你释放该分页之后才能访问。如果升级到表锁,则同一时间,该表中的记录只能一个人才能访问,其他人不能访问。如下图。
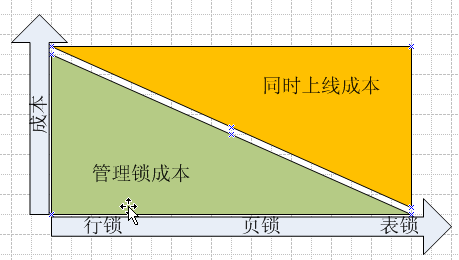
一般情况下,是不需要手工去设置锁定范围的,可以由Microsoft SQL Server 数据库引擎视情况而定,使用动态锁定策略确定最经济的锁。 执行查询时,数据库引擎会根据架构和查询的特点自动决定最合适的锁。 例如,为了缩减锁定的开销,优化器可能在执行索引扫描时在索引中选择页级锁。
动态锁定具有下列优点:
· 简化数据库管理。 数据库管理员不必调整锁升级阈值。
· 提高性能。 数据库引擎通过使用适合任务的锁使系统开销减至最小。
· 应用程序开发人员可以集中精力进行开发。 数据库引擎将自动调整锁定。
在 SQL Server 2008 中,锁升级的行为已发生改变,其中引入了 LOCK_ESCALATION选项
原文:https://www.cnblogs.com/DataArt/p/10329179.html