
用python 编写爬虫程序,从网络上爬取相关主题的数据
import requests
from bs4 import BeautifulSoup as bs

def getreq(url):
    header = {‘user-agent‘:‘Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.115 Safari/537.36‘}
    html = requests.get(url,headers=header).content.decode(‘GB2312‘,‘ignore‘)
    return html
def gettext(html):
    soup = bs(html,‘html.parser‘)
    info = soup.select(‘div[class="mod newslist"] ul li a‘)
    return info
if __name__==‘__main__‘:
    url = "http://sports.qq.com/l/isocce/yingc/manu/mu.htm"
    html = getreq(url)
    print(html)
    info = gettext(html)
    for i in info:
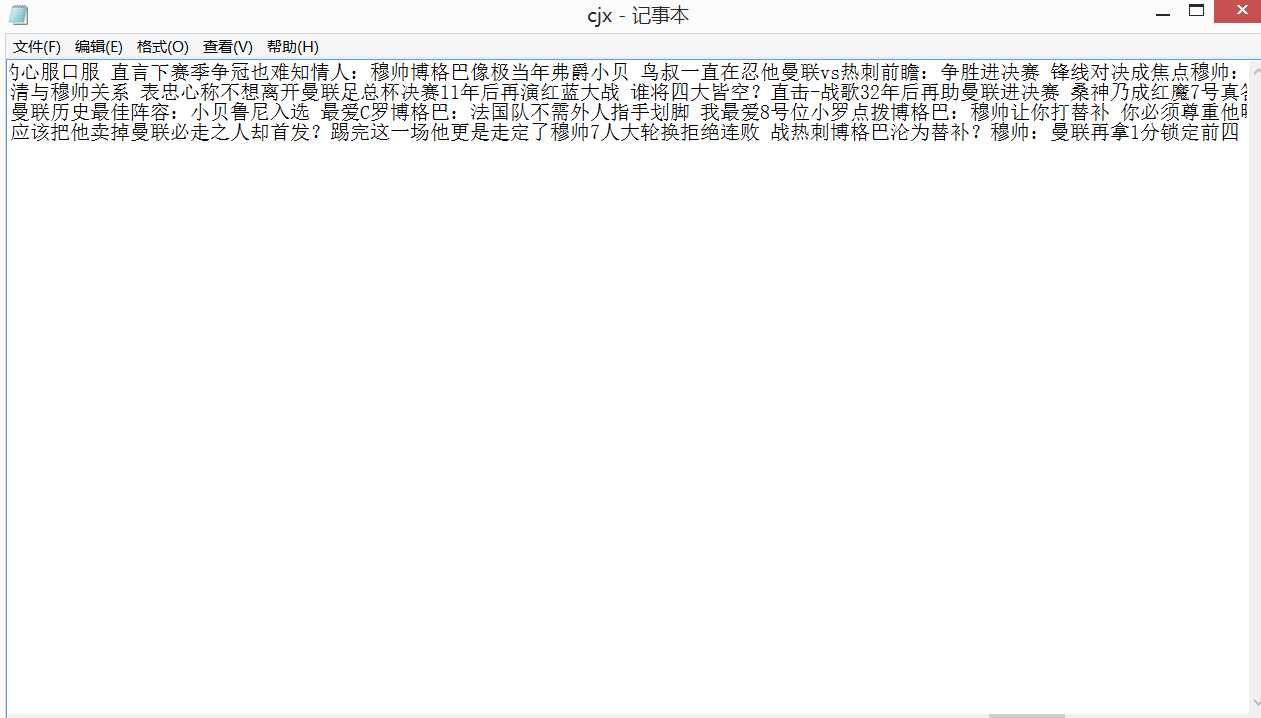
        f = open(‘cjx.txt‘, ‘a+‘, encoding=‘utf-8‘)
        f.write(i.get_text())
        f.close()
对爬了的数据进行文本分析,生成词云
import jieba
import PIL
from wordcloud import WordCloud
import matplotlib.pyplot as p
import os


path = "C:\\Users\\guoyaowen\\Desktop"
info = open(‘cjx.txt‘,‘r‘,encoding=‘utf-8‘).read()
text = ‘‘
text += ‘ ‘.join(jieba.lcut(info))
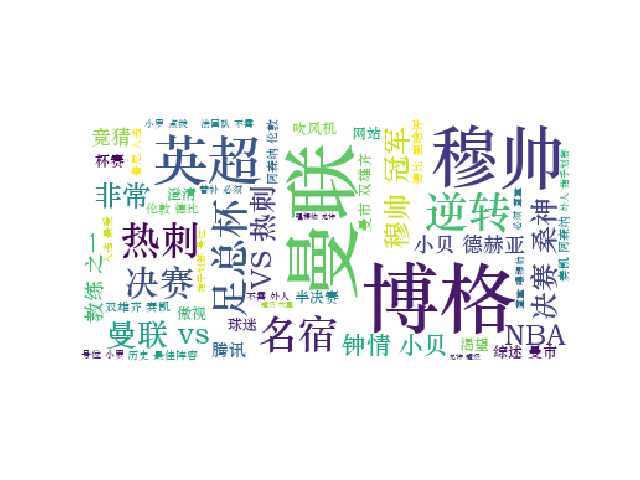
wc = WordCloud(font_path=‘C:\Windows\Fonts\STZHONGS.TTF‘,background_color=‘White‘,max_words=50)
wc.generate_from_text(text)
p.imshow(wc)
# p.imshow(wc.recolor(color_func=00ff00))
p.axis("off")
p.show()
wc.to_file(‘cjx.jpg‘)
原文:https://www.cnblogs.com/SCJX/p/8929853.html